RAG 檢索增強生成:讓 AI 先找資料再回答
RAG 是什麼?為什麼它是提升 AI 回答品質的核心方法?從檢索、增強、生成三步驟,到資料怎麼準備、問題怎麼問、結果怎麼排序,非工程師也能看懂。
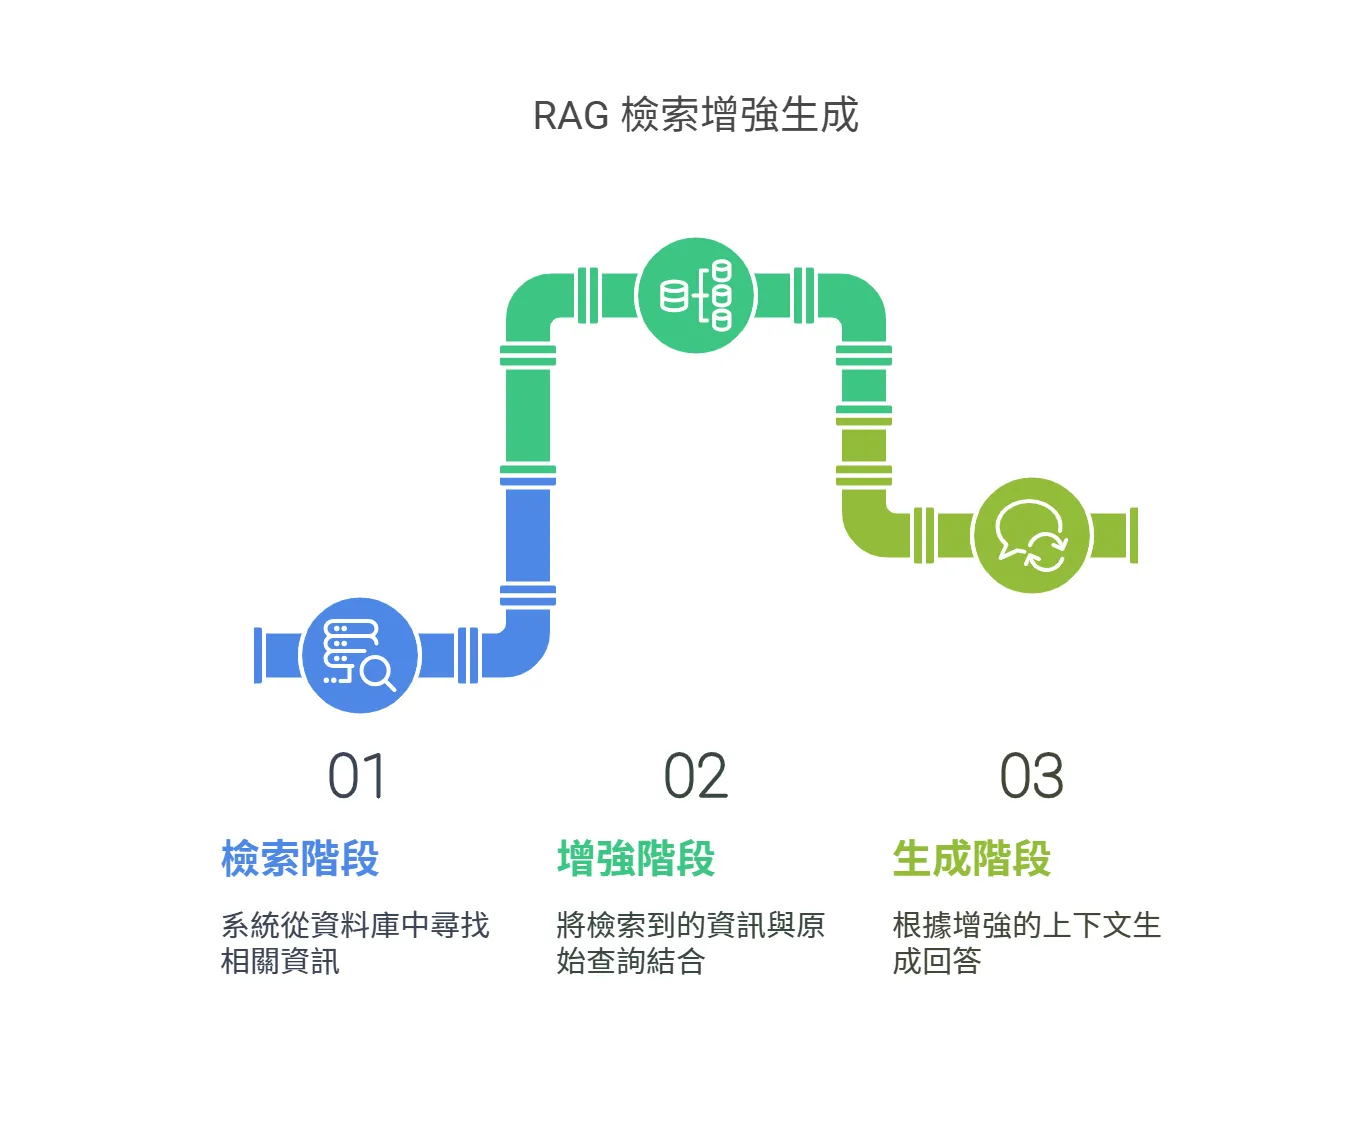
RAG 是一種將「找資料」與「寫回答」結合的生成方式,全名為 Retrieval-Augmented Generation(檢索增強生成)。這類系統在回答問題時,會經過三個關鍵步驟:
- 檢索(Retrieval):
模型收到你的提問後,會先到指定的資料庫(如企業內部文件、FAQ、知識庫)中尋找最相關的資訊片段。 - 增強(Augmentation):
找到的資訊會與你的原始提問一起組成新的上下文,變成語言模型的輸入,也就是「幫它補上它本來不知道的資訊」。 - 生成(Generation):
最後再由語言模型根據這些補充過的上下文,來生成最終回答。
這種方式的好處是:
不需要重新訓練模型(如 Fine-tuning),卻能做到針對性更強的回應,也能即時更新知識、控制資訊來源。
雖然 ChatGPT 本身已經具備一定的 RAG 概念(像是文件引用或上網搜尋),但如果希望回答內容更精準、更可信、更符合任務需求,通常會進一步搭配其他模型來分工協作,並細化每個步驟中的參數與行為邏輯,建構屬於 AI 自己的工作流程。
例如,一個完整的 RAG 架構可以長這樣:
- 使用者提問
使用自然語言輸入一個問題。 - 向量化(Embedding)
將提問轉換成向量,由專門的**內嵌模型(Embedding Model)**負責,把文字轉換為可比較的數字特徵格式。 - 資料檢索(Retrieval)
使用轉換後的向量,在**向量資料庫(Vector Database)**中比對出前 N 筆最相似的內容。 - 排序強化(Re-ranking)
對這些相似內容進行第二層排序,可能依據語意深度、來源可信度、任務適配性等,由重排序模型(Rerank Model)來判斷哪些資料應該優先被放入上下文。 - 上下文補強(Augmentation)
根據排序結果選定最有價值的幾筆資料,組合成補充上下文。 - 回答生成(Generation)
將補強後的上下文與原始問題一併餵給大型語言模型(LLM),進行回答生成。
透過這樣的細緻流程,每一個環節都可以獨立優化,從向量模型的選擇、資料庫建構邏輯、排序策略、生成模型,每一層都會影響最終回答的品質。
增強向量化(Vectorization)的品質
不論是「使用者的提問」或是 RAG 所利用的「資料庫內容」,都需要轉換成向量,才能讓模型進行比對並產生回答。因此,
讓文字被更準確地轉換為向量,是決定回答品質的第一步。
而想要做好向量化,會有兩個關鍵重點:
- 讓內容本身更適合轉換成向量
- 使用更強的向量轉換工具(也就是 Embedding 模型)
對大多數人來說,第二項比較難改變——我們能做的,主要是選擇一個品質較高、較適合我們內容的 Embedding 模型(如 OpenAI、Cohere、BGE 等),但選擇本身仍需經過測試與驗證。
而第一項,「如何準備內容」,則是每個人都能主動做好的點。
在〈聽說GPT很強,為什麼別人用起來感覺比較好?〉提到:「要讓 AI 更好的回答問題,打字要打完整,並用常使用的語句,不然容易預測錯誤(拆字拆錯)」
上述只是一個簡化的概念,要能更好的進行向量化,還有很多種方式,例如:
| 項目 | 建議做法 | 說明 |
|---|---|---|
| 資料格式 | 避免 PDF,改用 Markdown、純文字、JSON | PDF 雖然好閱讀,但需要進行辨識、重新分段,常導致模型誤讀。 Markdown、JSON 等資料型態,層級清晰,更容易形成語意一致的段落向量。 (其他常見資料型態:docx、txt、xlsx…等都是) |
| 文字分段 | 每一段文字控制在 300~500 tokens 左右,並語意連貫、不要硬切句 | 分段太長會讓模型無法聚焦,太短又缺乏足夠訊息,亂切則容易讓回答跑偏。 適當的進行文字分段,會讓模型理解品質更好。 |
| 層級分類 | 使用標題、子標題…等,或是把同一類別的資料集中在同一份文檔、文字區域 | 段落上下文會影響語意建構,明確的層級與組織能幫助模型建立更準確的語意分層。 例如 Word 文件裡面就有分段的工具,Markdown 則是用「#」來表示大小標題。 |
| 統一語言、標準詞彙 | 統一用詞(如:「會員登入」不要有「使用者登入」「登入平台」混用),甚至建立特殊名詞的一覽表 | 向量是語意空間的表示。 不同詞會被分配不同向量,用詞混亂會讓相似內容無法正確比對。 統一用詞並搭配適當的詞彙說明,會讓品質更好。 |
| 資料清洗 | 移除空白欄位、多餘格式、極端值或與任務無關的段落 | 噪音太多會干擾語意建構,讓重要內容在向量空間中被「稀釋」或「偏移」。 |
檢索 Retrieval:讓 AI 找到對的資料
RAG 中的「檢索」階段,是指系統根據使用者的提問,從資料庫中找出最相關的段落,放進語言模型的上下文中作為回答依據。
這裡的「比對」並不是看哪些字重複多次、或單純關鍵字搜尋。(當然,也會混合使用)
主要的方法是將問題與資料都轉換成數字向量,計算這些數字(向量)之間的距離,距離越近,代表語意越接近。這樣的語意比對,是可以透過程式語言(例如 Python)實作的,也是目前多數 AI 應用中常見的做法。
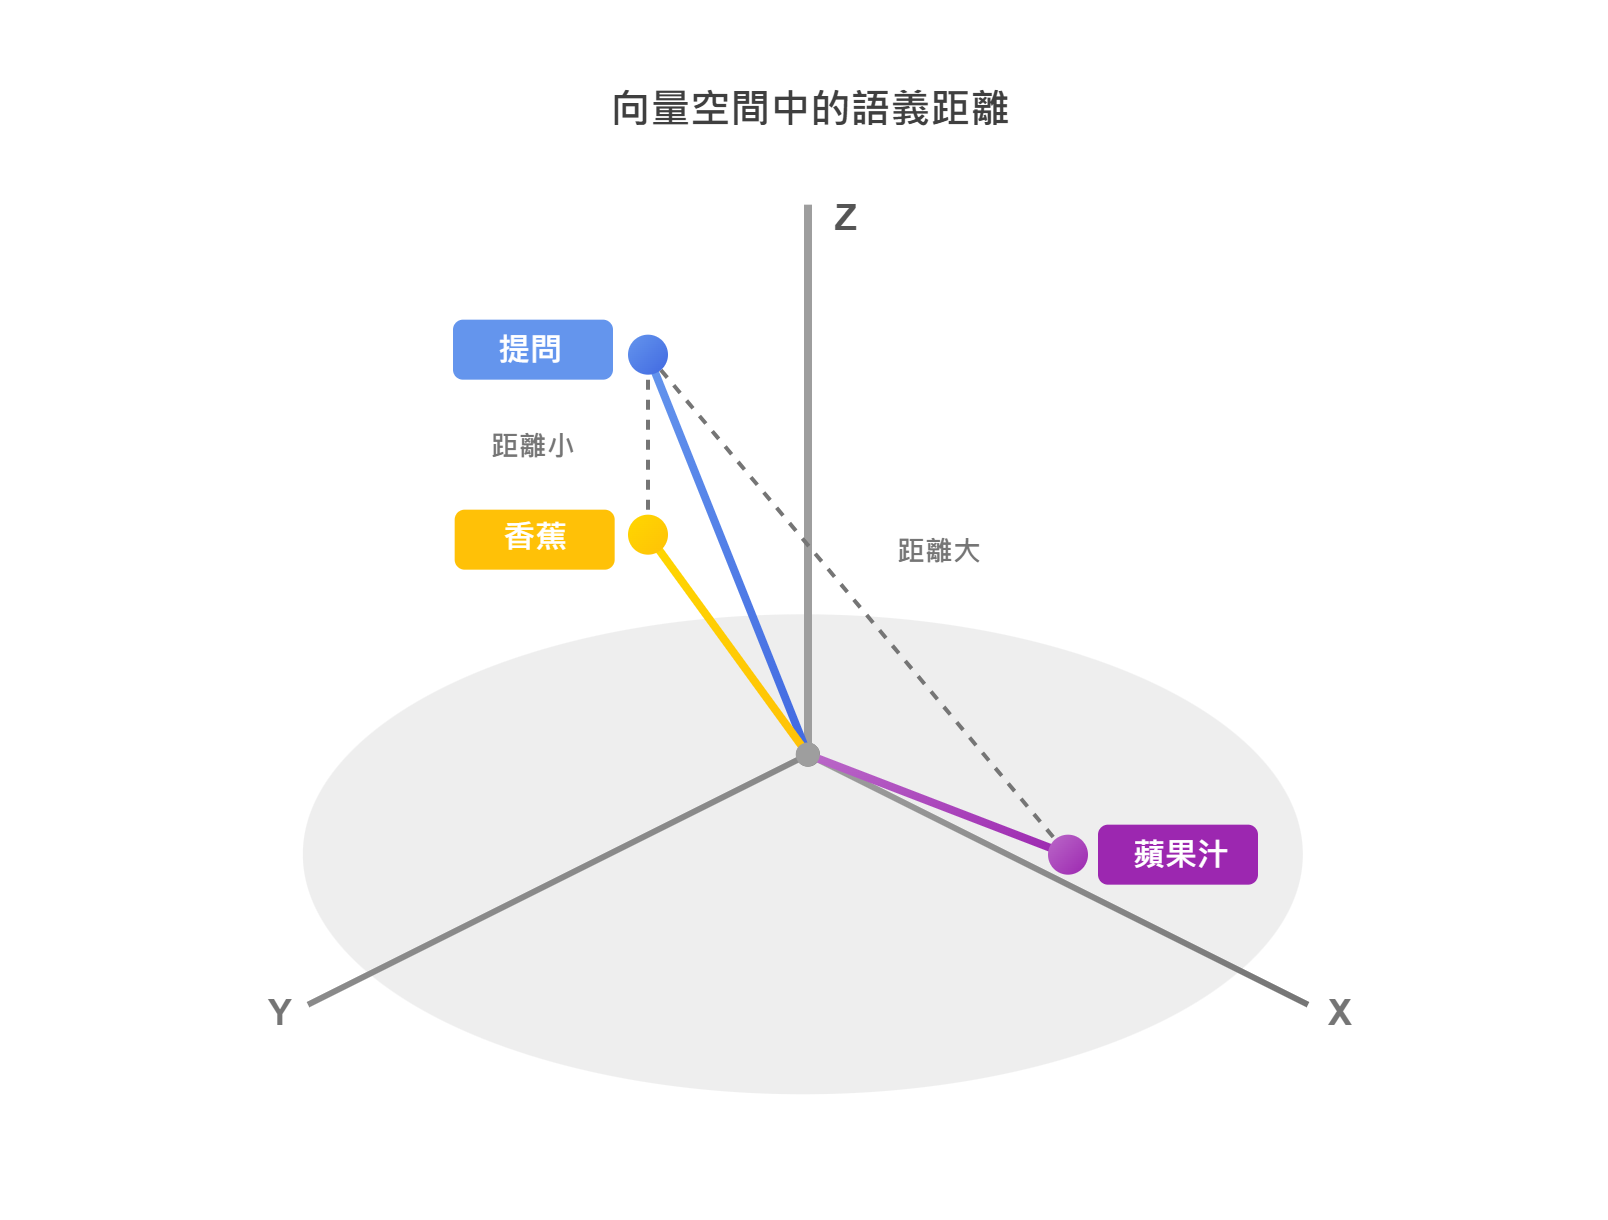
雖然我們不一定能學會如何進行比對、設計資料庫、調整向量模型,但仍可以從兩個實務層面著手,來進一步優化檢索效果:
- 檢索前的準備策略
- 檢索後的排序優化
檢索前:讓問題更容易被「命中」
| 方法 | 說明 | 具體案例 |
|---|---|---|
| 拆解問題再合併 | 複合式提問會導致語意分散,拆成單一目標更容易比對成功 | 問題:「我們的退款流程與規則是什麼?」 拆成:① 退款流程是什麼?② 退款條件有哪些? 用拆解後足夠小、精細的問題檢索,等 LLM 回答前再整合 |
| 多次提問取交集 | 同一意圖用不同表達法提問,取多次檢索結果中重複出現的內容以提高準確率 | 想問「報帳流程」,可改為:①「報帳需要哪些步驟?」②「請款流程是什麼?」③「我完成消費後,要怎麼報帳?」 三組提問可能各自抓到不同段落,同一資訊在多個檢索結果中重複出現,就可以作為更可信的共識依據,然後才選擇資料回答。 |
| 加入關鍵詞限制 | 向量檢索可能忽略關鍵詞,增加關鍵字搜尋的條件,確保包含必要字詞(如:法規、技術用語) | 查「預付費的方案」,但向量檢索只返回含「付款機制」的模糊內容。 改成查詢:「請列出方案,內容中包含 '預付費' 或 '先付款' 關鍵字」進行檢索。 |
檢索後:用模型排序出「真正最相關的」
即使向量比對最接近的結果,排名結果也未必最合理。因為:
- 向量是壓縮過的語意表示,本身就有損失、誤差
- 相似度排序只是數值相近,不等於語義最貼合
這時就可以使用 Rerank 模型,根據使用者提問的上下文,重新判斷多個候選段落的相關性,排序出更貼近語意的結果。例如一開始檢索結果排序如下:
提問:「猜我喜歡的水果」→ 檢索得到以下結果:

1. 蘋果醋
2. 香蕉汁
3. 榴槤

(向量排序結果)
這三者看似都合理,但實際上「榴槤」才是水果,卻因為關鍵詞罕見之類的原因,排名較後面。
透過 Rerank 模型重新排序後,AI 就有機會把「榴槤」放在第一順位,給出正確的答案。
從「回答問題」到「完成任務」
到這裡,我們學會了許多讓 AI 給出好答案的方法,但很快會碰到兩個實際問題:
- 為了一個答案,要分成好幾步驟來做,太麻煩了!
- 我們真正要的,其實不只有「答案」,而是「完成某件事」
- 問怎麼寫報表,是為了完成這季的營收報表
- 問怎麼寫程式,是為了做出一個網站
- 問怎麼寫 Email,是為了發出一批廣告郵件
AI 的角色也因此從「內容回答者」轉向「任務完成者」,邁向下一個階段:「流程化 + AI Agent」