從上下文 Context 開始,強化 AI
想讓 AI 回答得更好,關鍵在「上下文」。從 Token 上限、Prompt 提示詞、微調,到讓 AI 自己上網、讀你給的檔案,一次看懂強化 AI 的幾種方法。
上一篇提到,想讓 AI 回答得好,最重要的是提供更清楚的上下文。這篇就來看看,關於上下文還有哪些細節,可以讓我們強化 AI。
Token 數量
每次 GPT 推出新版本時,常會提到:「我們把 Token 上限提高了」,意思是:它在回答時,能參考的上下文變多了。
你可以把這想像成:一個學富五車的科學家,早期因為有「短期記憶障礙」,只能回答你剛剛那一句話,太長或深入的討論,他馬上忘記你前面問過什麼。
但隨著 Token 數量的提升,現在主流的模型多半能處理數十萬、甚至上百萬個 Token,相當於一次讀完好幾本書。這個「健忘的科學家」終於能把你整段提問、前面背景、甚至你提供的說明文件都記進去,理解變得更完整。
而如果你的帳號啟用了記憶功能(Memory),模型甚至會記得你常問什麼、偏好什麼風格,未來會主動根據這些偏好來調整回應內容。
咒術師、Prompt 提示詞
GPT 剛推出時,有一群人專門研究怎麼讓 AI 給出更好的答案,他們被戲稱為「咒術師」,其實就是擅長撰寫 Prompt 提示詞的人。
Prompt 提示詞是你輸入給 AI 的指令或引導,用來幫助它理解任務目標、角色設定與語氣方向。它屬於上下文的一部分,是模型用來判斷「你到底想幹嘛」的第一手依據。
比如,如果你只是單問:「你好嗎?」,模型可能會很普通地回答:「我很好,謝謝你的關心。」
但如果你先加上一些提示詞,情況就會完全不同:
- 我想要比較不同大型語言模型的優劣
- 我是一位設計師,現在需要製作一張 AI 生成的圖片
- 回答時請保持誠實、不偏袒任何品牌
然後再問:「你好嗎?」或「你推薦哪個模型?」
這樣模型就能更準確地對齊你的目的,產生更有針對性的回答。
後續訓練與「微調(Fine-tuning)」
如果我們不想要一直提供上下文怎麼辦?它不能自己聰明一點嗎?
這正是許多企業與專業領域的挑戰。
尤其是法律、醫療、會計有專業、精準的需求;
企業內部文件、產品客服知識屬於非公開的文件,無法公開提供學習。
而這些內容可能龐大又複雜,光靠一段 Prompt 又難以讓 GPT 給出正確答案。
為了解決這個問題,我們需要再次訓練模型。
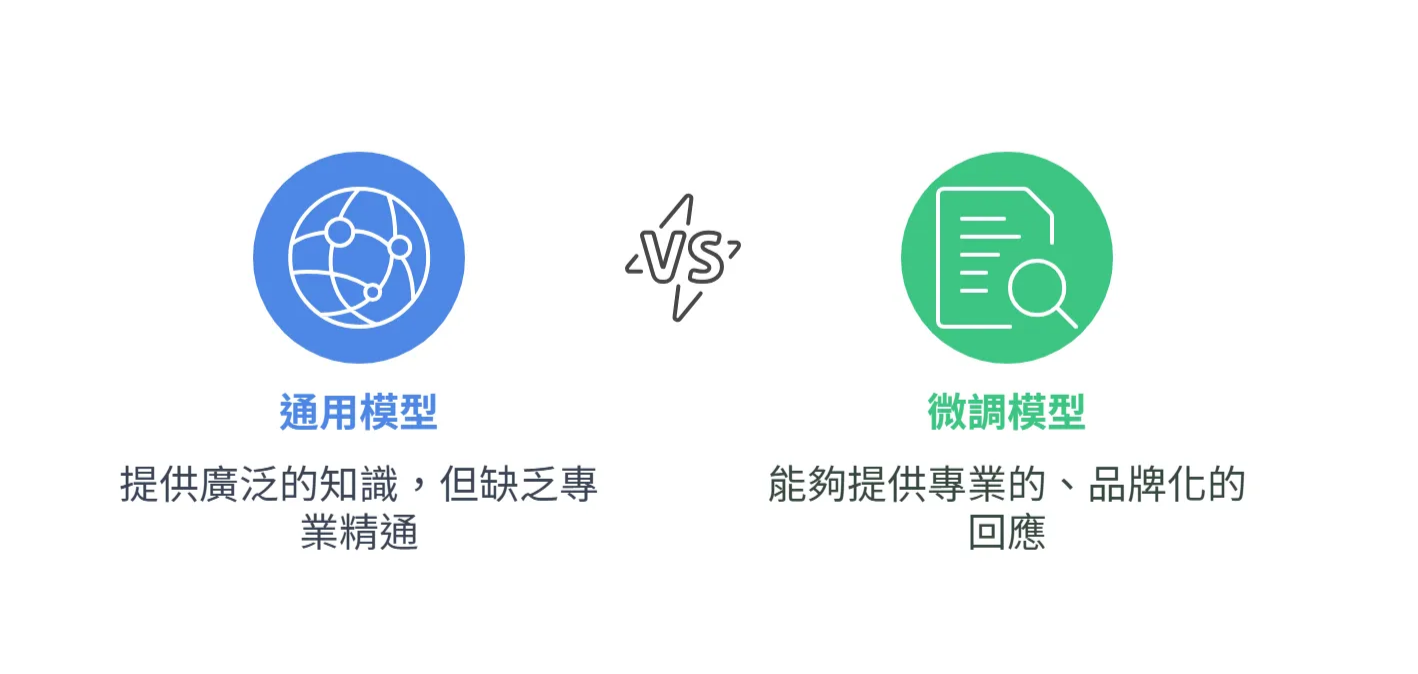
GPT 名稱中的「P」代表「預訓練(Pre-trained)」,表示模型在一開始就已經閱讀過大量資料。然而這樣的通用知識,對某些公司或專業場景來說還不夠,我們需要的是一個更懂這個領域的模型。
這時會使用一種事後訓練技術,叫做「微調(Fine-tuning)」。(這個技術只是其中一種選項)
企業會選擇現成的大型語言模型,例如 GPT 或 DeepSeek,接著提供特定領域的大量資料進行第二階段訓練,讓模型學會如何在這類情境下回答問題。
這些資料可能包括最新法律規定、企業內部文件、技術規格,甚至某品牌的語氣風格指南。
經過訓練後,這個模型就不再只是通用助手,而是能夠回答你公司內部文件、用品牌語氣寫文案的 AI 員工。
讓 GPT 自己找資料!
當許多企業還在設法進行模型微調時,GPT 卻開始具備了查詢網路資訊的能力,這帶來了重大的改變。
就像一位在書海苦讀十年的大師,能對你提出的問題侃侃而談。但隨著時間過去,這位大師掌握的知識終究會逐漸過時,面對最新的法規、產品或新聞,他就會顯得有點跟不上。
當 GPT 能「自己上網找資料」後,解決了兩個長期限制它能力的關鍵問題:
- 上下文可以自行蒐集:使用者不再需要手動整理、餵資料,它能根據問題自動搜尋合適內容
- 資訊具有時效性:模型不再受限於訓練資料時間點,可以掌握最新的資料、數據與觀點
這表示,所謂「好的上下文」不只代表內容量多、資料正確,現在還加入了兩個新條件:資訊新、提供快。
也因此,具備搜尋能力的 GPT,不再只是回答預訓練階段的知識,而是能主動查找新資料並整合上下文內容的回應系統。
讓它自己找,但限縮資料範圍
隨著幾次的改版,GPT 開始支援附加文件檔案作為輸入方式。
換句話說,它可參考的上下文,到目前共出現了三種重要形式:
- 你和 AI 的對話文字
- 網路上的即時資訊
- 你提供的檔案或限定內容(PDF、Excel、Word…等)
前面提過,當上下文混亂、主題跳躍時,模型很難判斷哪些資訊是重點(像牛肉麵 vs. 股票)。
但如果你能明確說明問題、提供對應的參考資料,它的回答品質會有明顯提升。
像是:公司的產品型錄 PDF、每季財報 Excel、會議記錄 Word 等常見檔案,只要轉成能被模型讀懂的格式,GPT 就能以此為依據,給出更具專業性與上下文對齊的回應。
除了提供檔案,有些人也會把 AI 過去的回應整理起來,標示出哪些是正確的,再當作補充資料回傳給模型參考。這種方式看起來像是在「教 AI 答題」,實際上也是在幫它建構更清晰的上下文,讓它更知道你期待什麼樣的答案。
這個做法跟訓練模型時使用的 RLHF(Reinforcement Learning from Human Feedback,人類回饋強化學習) 不太一樣。
RLHF 是在模型訓練階段,由人類挑選較好的回應,幫助模型調整內部參數。
而上文所提到的,只是把你認為更好的內容,用「文件」或「語句」的形式餵給它參考,屬於補充上下文,不是重新訓練。
就像我們在企業中解決問題時,你的專業能力是核心,企業內部文件幫你更快更準確完成任務,而外部資源與市場資料則能補足最新觀點、擴展方向。
AI 也是將**問題本身成為核心,檔案提供精準依據,網路資料補上時效性,**三者結合讓模型回應的品質得到大幅提升。
而這種「先找資料、再產生回答」的技術架構被稱為 RAG(Retrieval-Augmented Generation),也是目前提升 AI 回答品質的核心方法之一,裡面也涉及不少的技術,讓我們在下一篇繼續一探究竟。