數據、算力、算法:AI 的三大基礎
ChatGPT 為什麼這麼厲害?從數據、算力、算法三個基礎,看懂 AI 模型能不能成功的關鍵,以及 DeepSeek 為什麼曾經震動整個 AI 產業。
我們都希望 ChatGPT 給出的內容是有用的、正確的、可靠的,那就得從更底層來看它為什麼能這麼厲害。AI 模型的本質,建立在三大核心基礎上:
數據(Data)、算力(Compute) 和 算法(Algorithm)。
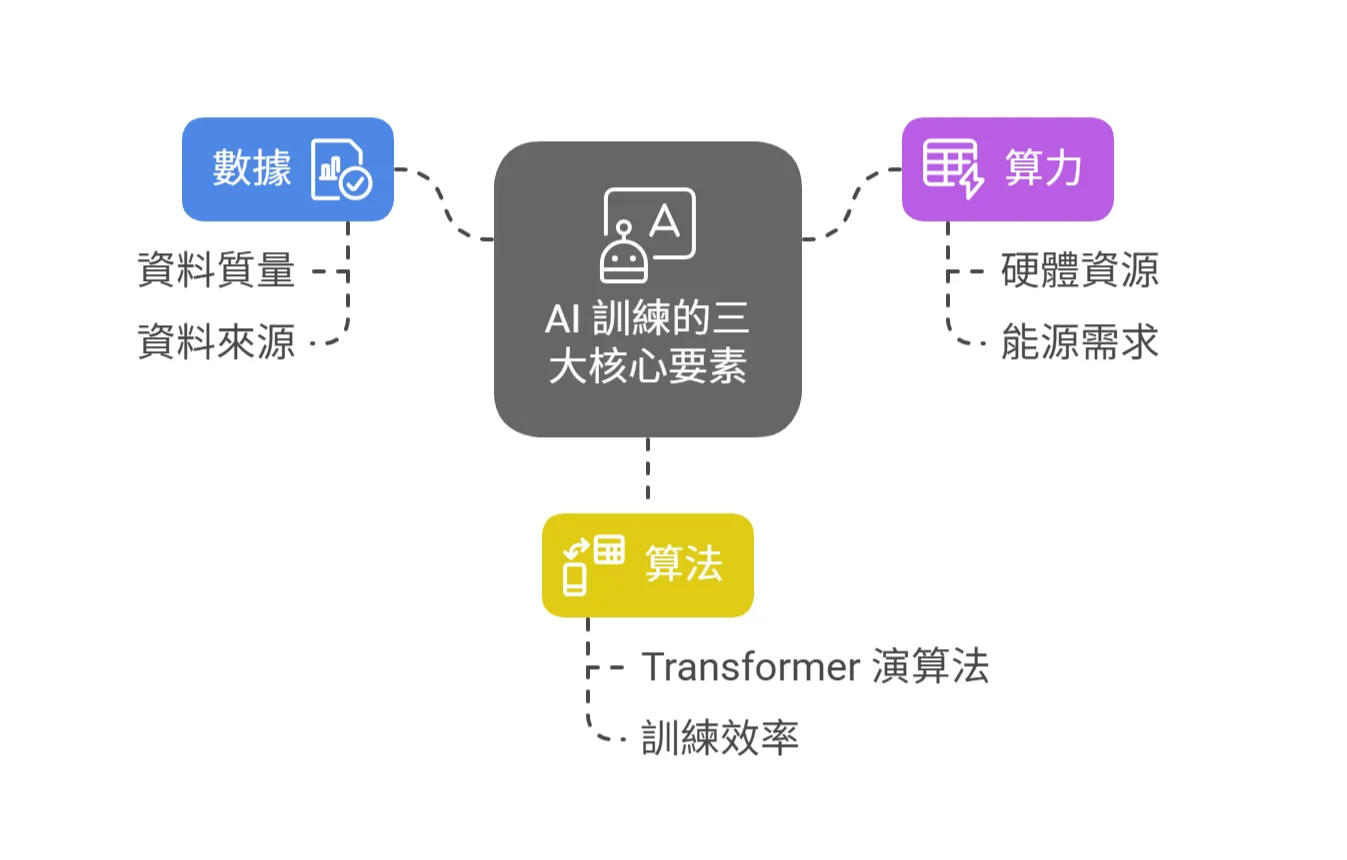
數據(Data):輸入什麼,就學會什麼
AI 的訓練仰賴大量資料。但不只要「多」,還要「好」。
就像你在學習時,不是看書越多越好,而是內容要正確、有價值。AI 也是一樣,如果輸入的是錯誤、片面、甚至帶有操控目的的資料,它學到的結果自然會偏差。
現在就有一些公司刻意在網路上大量散布「優化過的虛假資訊」,例如,刻意讓某品牌在評論、社群、內容農場中表現更好,當 AI 蒐集這些內容來訓練時,就可能被誤導。
像 Perplexity 這類 AI 搜尋工具,就可能因為爬到錯的資料,最後引導消費者購買指定的產品。
算力(Compute):AI 的「能量來源」
訓練大型模型,需要大量的硬體資源,包括 GPU、RAM、儲存裝置等。這些硬體之於 AI,就像蛋白質之於人類一樣,是模型得以訓練與運作的「燃料」。
晶片越強大,訓練速度就越快,運行成本就越低;而晶片越便宜,服務就能以更合理的價格提供給用戶。這也是為什麼輝達(NVIDIA)、台積電這類公司在 AI 發展中扮演基礎建置的關鍵角色。
進一步來說,AI 發展對電力的需求也極高。這也是為什麼能源產業(如核能、石油)會被視為 AI 的「互補產業」。
算法(Algorithm):讓 AI 懂得「怎麼學、怎麼答」
算法決定了 AI 怎麼處理資料、如何判斷哪些資訊重要、以及怎麼產生回應。
對 GPT 來說,最關鍵的演算法是 Transformer,靠的是「注意力機制」來分配詞語間的權重,幫助模型產出更合理的結果。
好的演算法不只要「答得好」,還得「訓得快」「算得省」。
DeepSeek 為何震動整個 AI 生態
2025 年初,中國團隊 DeepSeek 釋出他們自研的大型語言模型,並引起兩大市場震撼:
- 訓練成本下降,算力需求降低
他們透過改進訓練方法,大幅降低算力成本,卻仍能產出 GPT 等級的效果,導致市場意識到晶片需求可能下降,也就是算力不需要這麼多,輝達與台積電等晶片股瞬間重挫。 - 開源衝擊
他們選擇公開模型,不用連線、不用付費也能在自己電腦上運行,對於其他提供封閉式 AI 服務的公司(如 OpenAI、Google)都產生估值壓力。
這三者的組合——大量好資料、足夠的算力、有效的算法——才是一個 AI 模型能否成功的關鍵基礎。任何一環出問題,結果就會變得不準、不快、不便宜,甚至「不可信」。
但我們並非訓練模型的人,多半也只是單純的用戶,理解這些對使用 AI 有幫助嗎?
有的,不過讓我們從 GPT 的理解方式開始,慢慢說明揭開它的重要性。