怎麼用 AI 算清楚,一個客服問題到底有多少人在問?
用 AI 分析客服紀錄,整包丟給它分類只看得出大概,算不出某一個問題到底有多少人在問。這篇分享一套做法:先寫清楚「什麼算、什麼不算」,交給便宜又快的 AI 模型 Jev 逐筆判斷,先拿 50 筆小考、對了九成以上才跑全部。實例是從三千多筆客服紀錄裡算出「客人找不到訂單」有多少筆,約 2 分鐘跑完,結果和請 Claude 逐筆讀的一致率超過九成。
— newadmin
「到底有多少客人在問這件事?」
想改善一個客服問題之前,最常卡在這一題。
例如「客人常找不到自己的訂單」,但到底多常?1000 多筆客服紀錄裡,是 10 筆,還是 100 筆?
這個數字很重要,它決定這件事值不值得改、改善之後,可以少掉多少通客服。尤其當客服是外包的,每一筆都是錢,一個問題如果很好解決,可能就能省下幾千到幾萬元,但數字算不準,如果還要花時間改動,這筆投資也可能不划算。
為什麼直接用 AI 會錯 ?
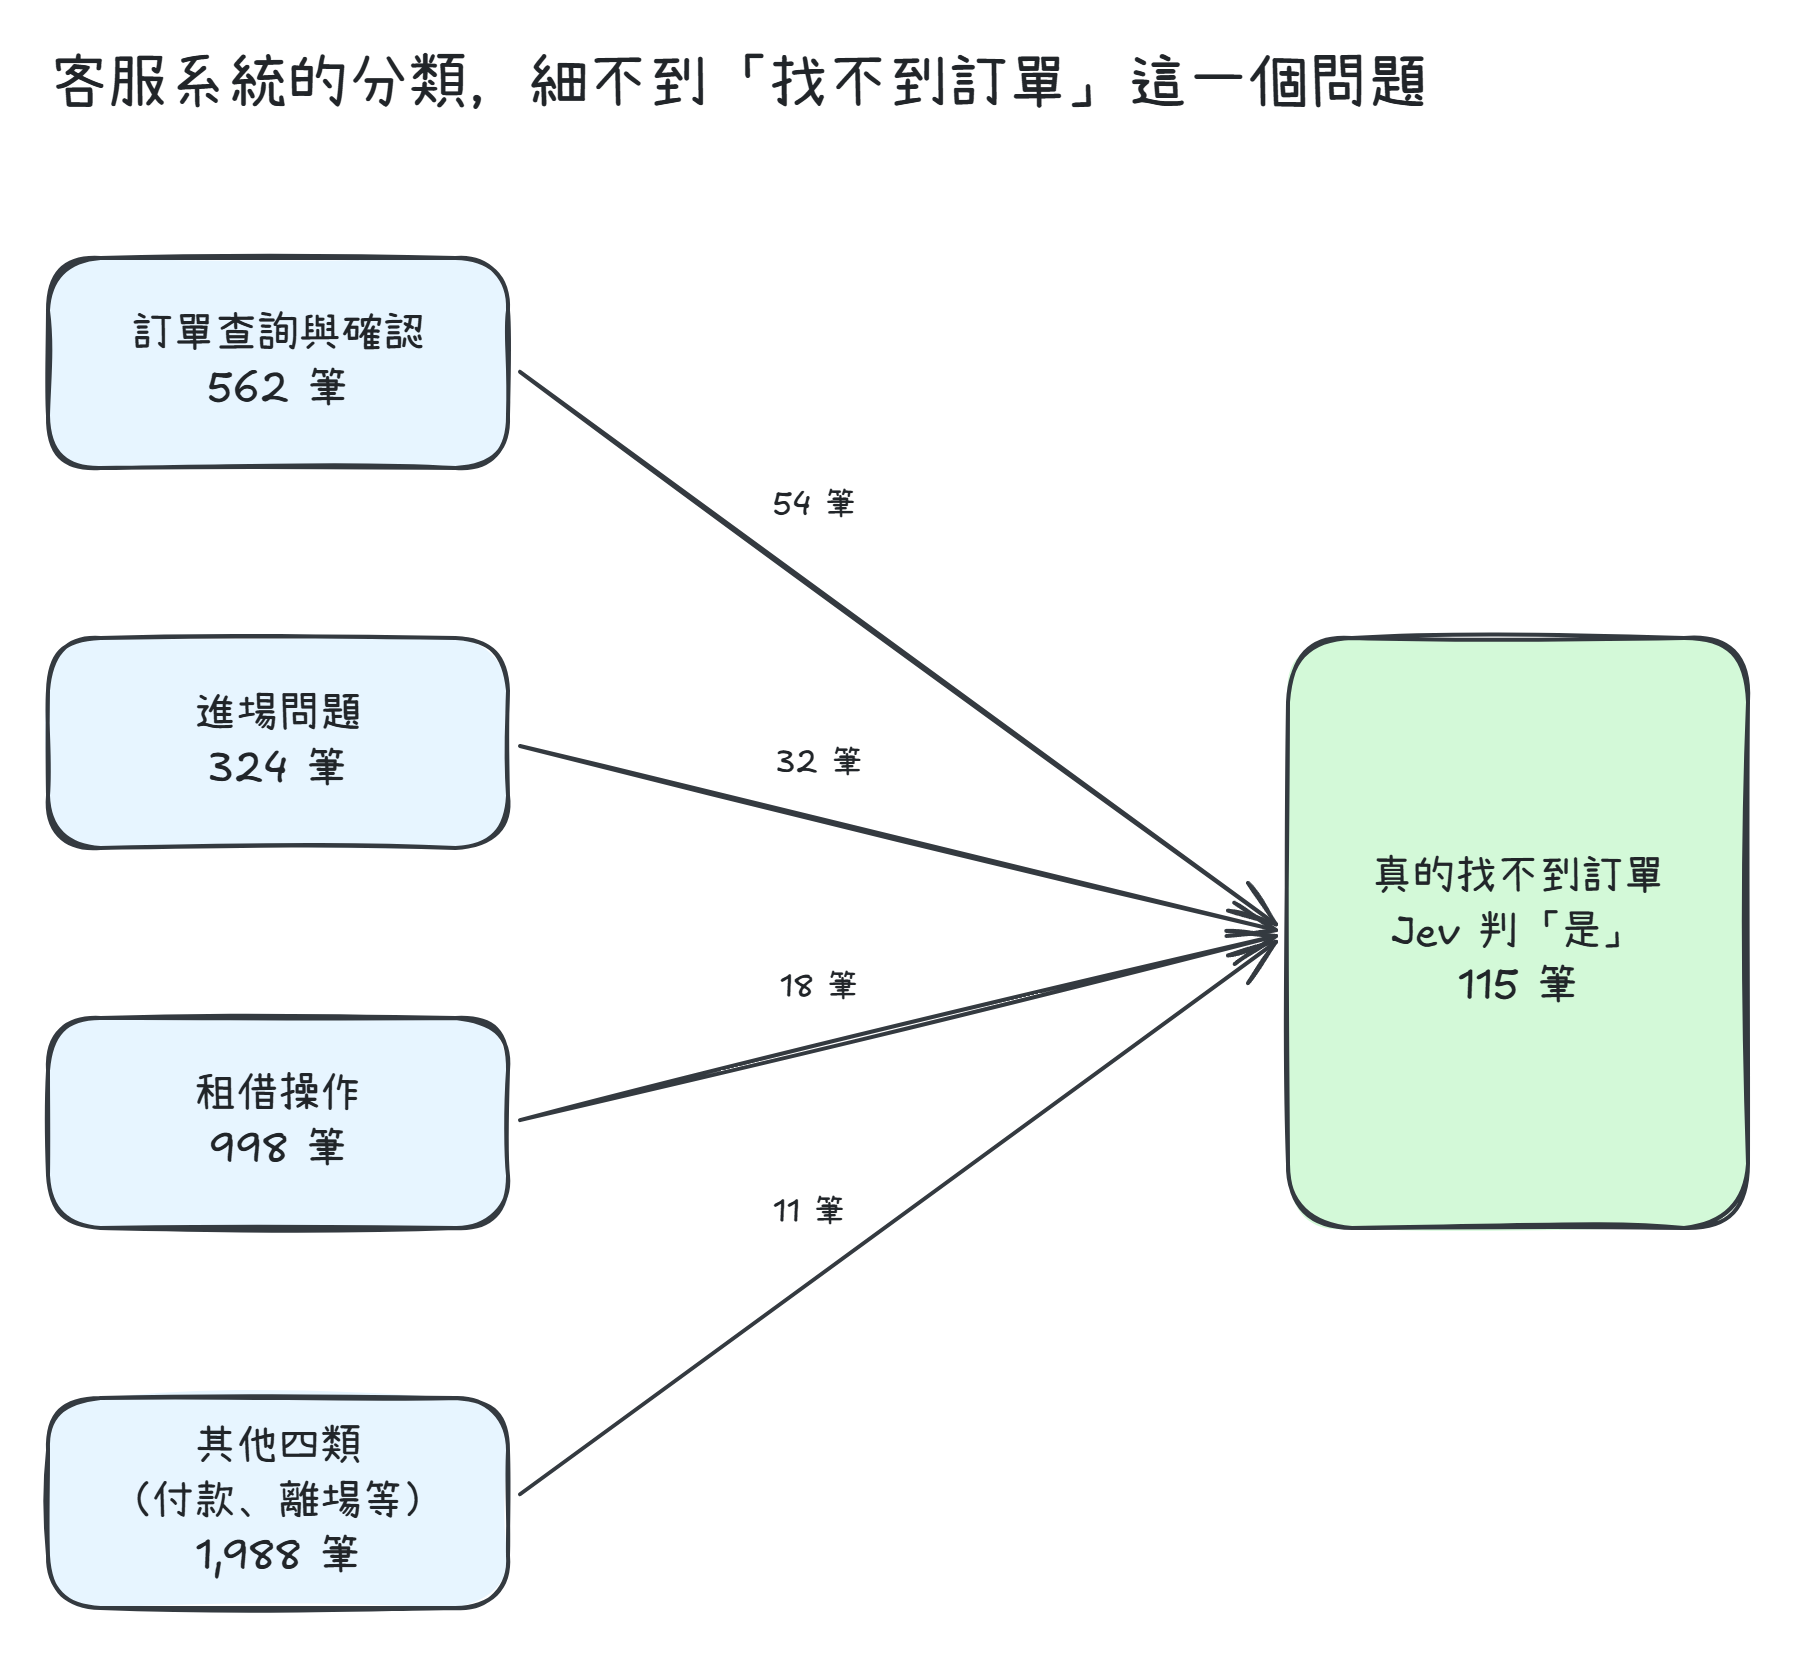
1.資料分類問題
我們的客服系統雖然本來就有分類,像「訂單查詢與確認」「進場問題」「付款問題」,但這些分類無法聚焦到「具體的問題」:同一個分類裡,常常混著好幾種問題;同一種問題,也會散在好幾個分類裡。
以這次的資料來說,三千多筆紀錄分在七個分類裡,光看「訂單查詢與確認」最像在找訂單,但五百多筆裡,真的是找不到訂單的只有五十幾筆,其他是在問可不可以改期、會不會超時被多收錢這類問題。反過來,找不到訂單的客人超過一半不在這個分類,而是散在「進場問題」「租借操作」等其他分類裡。
直接拿分類的筆數來算,就會差很多:看「訂單查詢與確認」有五百多筆,會以為問題很大;只算這個分類裡的,又會漏掉一半以上。
還有一個麻煩:我們的客服分類改版過,改版前後分法不一樣,同一種問題,改版前記在這一類,改版後可能記到另一類,想看一個問題是變多還是變少,光靠分類很難跨過改版前後來比。
2.無法統一具體問題
一般直覺的做法,是把全部紀錄丟給 AI,請它重新分類。
依我的經驗,這樣確實能看出個大概:一百種問題裡,抓出十到二十個比較有影響力的範圍,但回答的仍然是「大概有哪些種類、分別是多少」,回答不了「這一個問題到底有多少人在問」。
AI 重新分的類,也會碰到跟原本分類一樣的兩個問題:
- 分得太粗
AI 沒有足夠的背景,不知道怎麼分辨每個議題的差別,常把同一類底下不同的事情混在一起看。 - 同一件事被拆散
同一個問題被分到好幾個類別,每一類看起來都不多,你就以為問題不大。
方法概念
這次我換了一個做法:先讓 AI 幫我框出有影響力的範圍,再從裡面挑一個具體的問題,請 AI 一筆一筆判斷「算不算」,把這一個問題有多少人在問算清楚。
這次挑的,就是開頭那個「客人找不到自己的訂單」。
聽起來很單純,實際卻要仔細思考問題邊界。
客人來問訂單,不一定是找不到:可能是想取消、想改時間、想確認地點。這些直覺上都跟訂單有關,很容易被當成同一件事。
但我要找的只有一種:客人知道自己訂了,卻不知道去哪裡看。所以「不知道從哪裡取消」算,「可以改時間嗎」就不算,因為後者問的是規則。
另外有些情況看起來跟訂單有關,實際上不算,例如:
- 訂單原本找得到,後來不見了
- 付款失敗、系統沒產生訂單
- 只想確認有沒有扣款
這種描述性的邊界,用關鍵字搜尋處理不了,會抓到一堆不相干的,也會漏掉換個說法的客人。請 Claude 一筆一筆讀可以處理,但三千多筆讀下來,用量不小,速度也慢。
我這次的作法是:大量判讀交給 Jev,我和 Claude 負責出題和對答案,另外做了一個小網頁,讓標答案、改題目都只要點一下。
先認識 Jev
Jev 是 TypeSafe 做的模型,不寫文字,只回數字。問它「這位客人是不是找不到訂單才來問?」,它只回「是」的機率,像 0.92 或 0.05。(OpenAI 也推出了同樣的 Decisions API,不過目前看起來 Jev 還是便宜不少。)
因為只回數字,它又快又便宜:三千多筆交給 Jev,大約 2 分鐘就讀完,結果和 Claude 逐筆讀的一致率超過九成。
我把整件事想成一場考試:Jev 是考生,我和 Claude 負責出題和改考卷。先拿一小批試,對了九成以上才跑全部;不及格,就回頭把說明改清楚,再試一次。
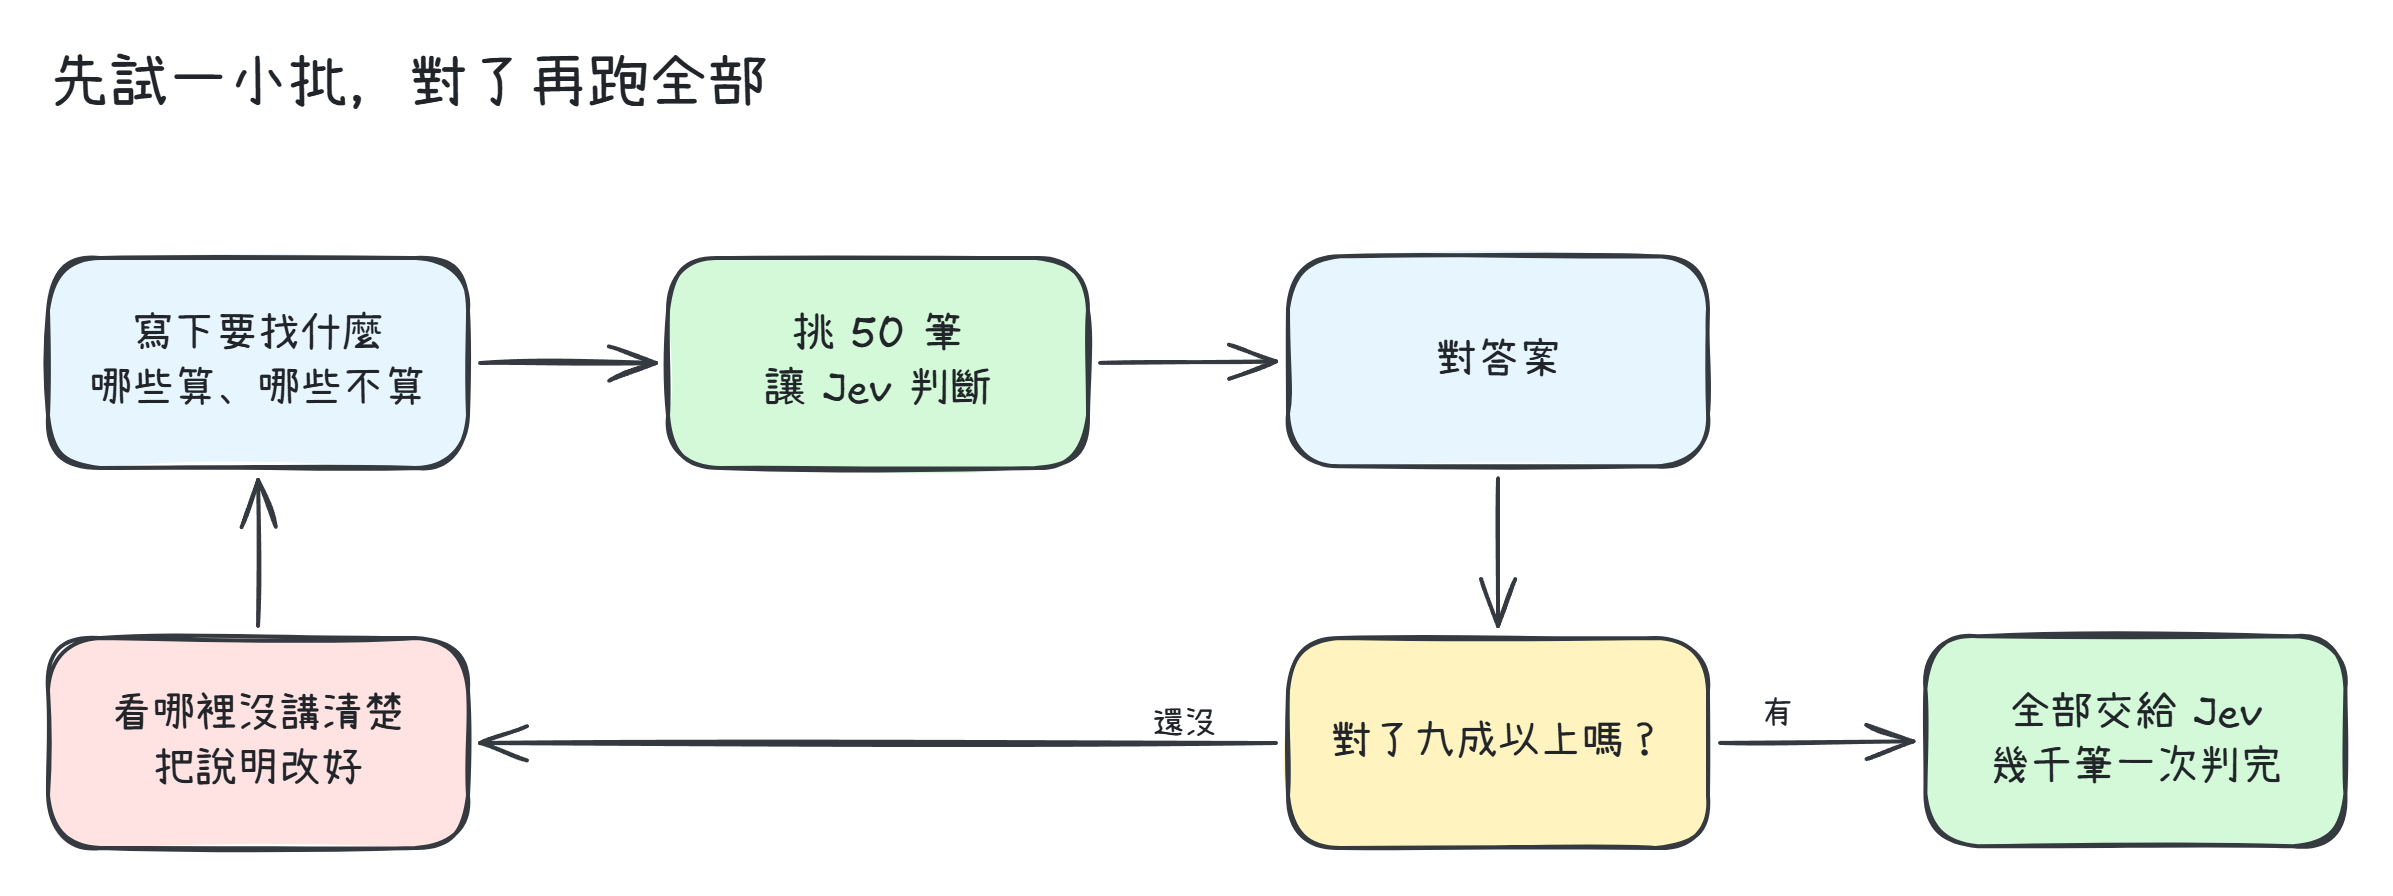
第一步:寫一張考題
考題就是一張「議題卡」,寫清楚三件事:
- 要問的是什麼(客人是不是因為找不到訂單才來問)
- 什麼算,附幾個例子
- 什麼不算,也附幾個例子
前面列的那些「看起來有關、其實不算」的情況,就是寫在這裡。
第二步:準備一份解答卷
光有考題還不夠,要有東西可以對答案。
訂單這個議題,則是先請 Claude 抽樣 100 筆,我再人工核對。
第三步:先小考,再大考
不要一開始就讓它讀全部,而是先抽 50 筆當小考,把它的答案和解答卷對一對,算出一致率。
一致率到九成以上,才讓它考全部;沒過,就再改。
第四步:沒過,就找出原因再改
把對不上的那幾筆拿出來看,找出錯在哪裡。如果是題目沒寫清楚,就補一句、改一句;如果是解答卷本身前後不一,就先把規則定下來,再把題目和解答卷一起改。
改完再考一次,過了九成,才放它讀全部三千多筆。
這是整個流程裡最實用的一段:對答案的過程,會逼你把原本模糊的定義講清楚。
讓人和 AI 好配合的小網頁
上面這四步,為了讓我看得懂、也好動手,我請 Claude 做了一個只在自己電腦上用的小網頁,把我需要動手的地方,都變成畫面上點一下就好。
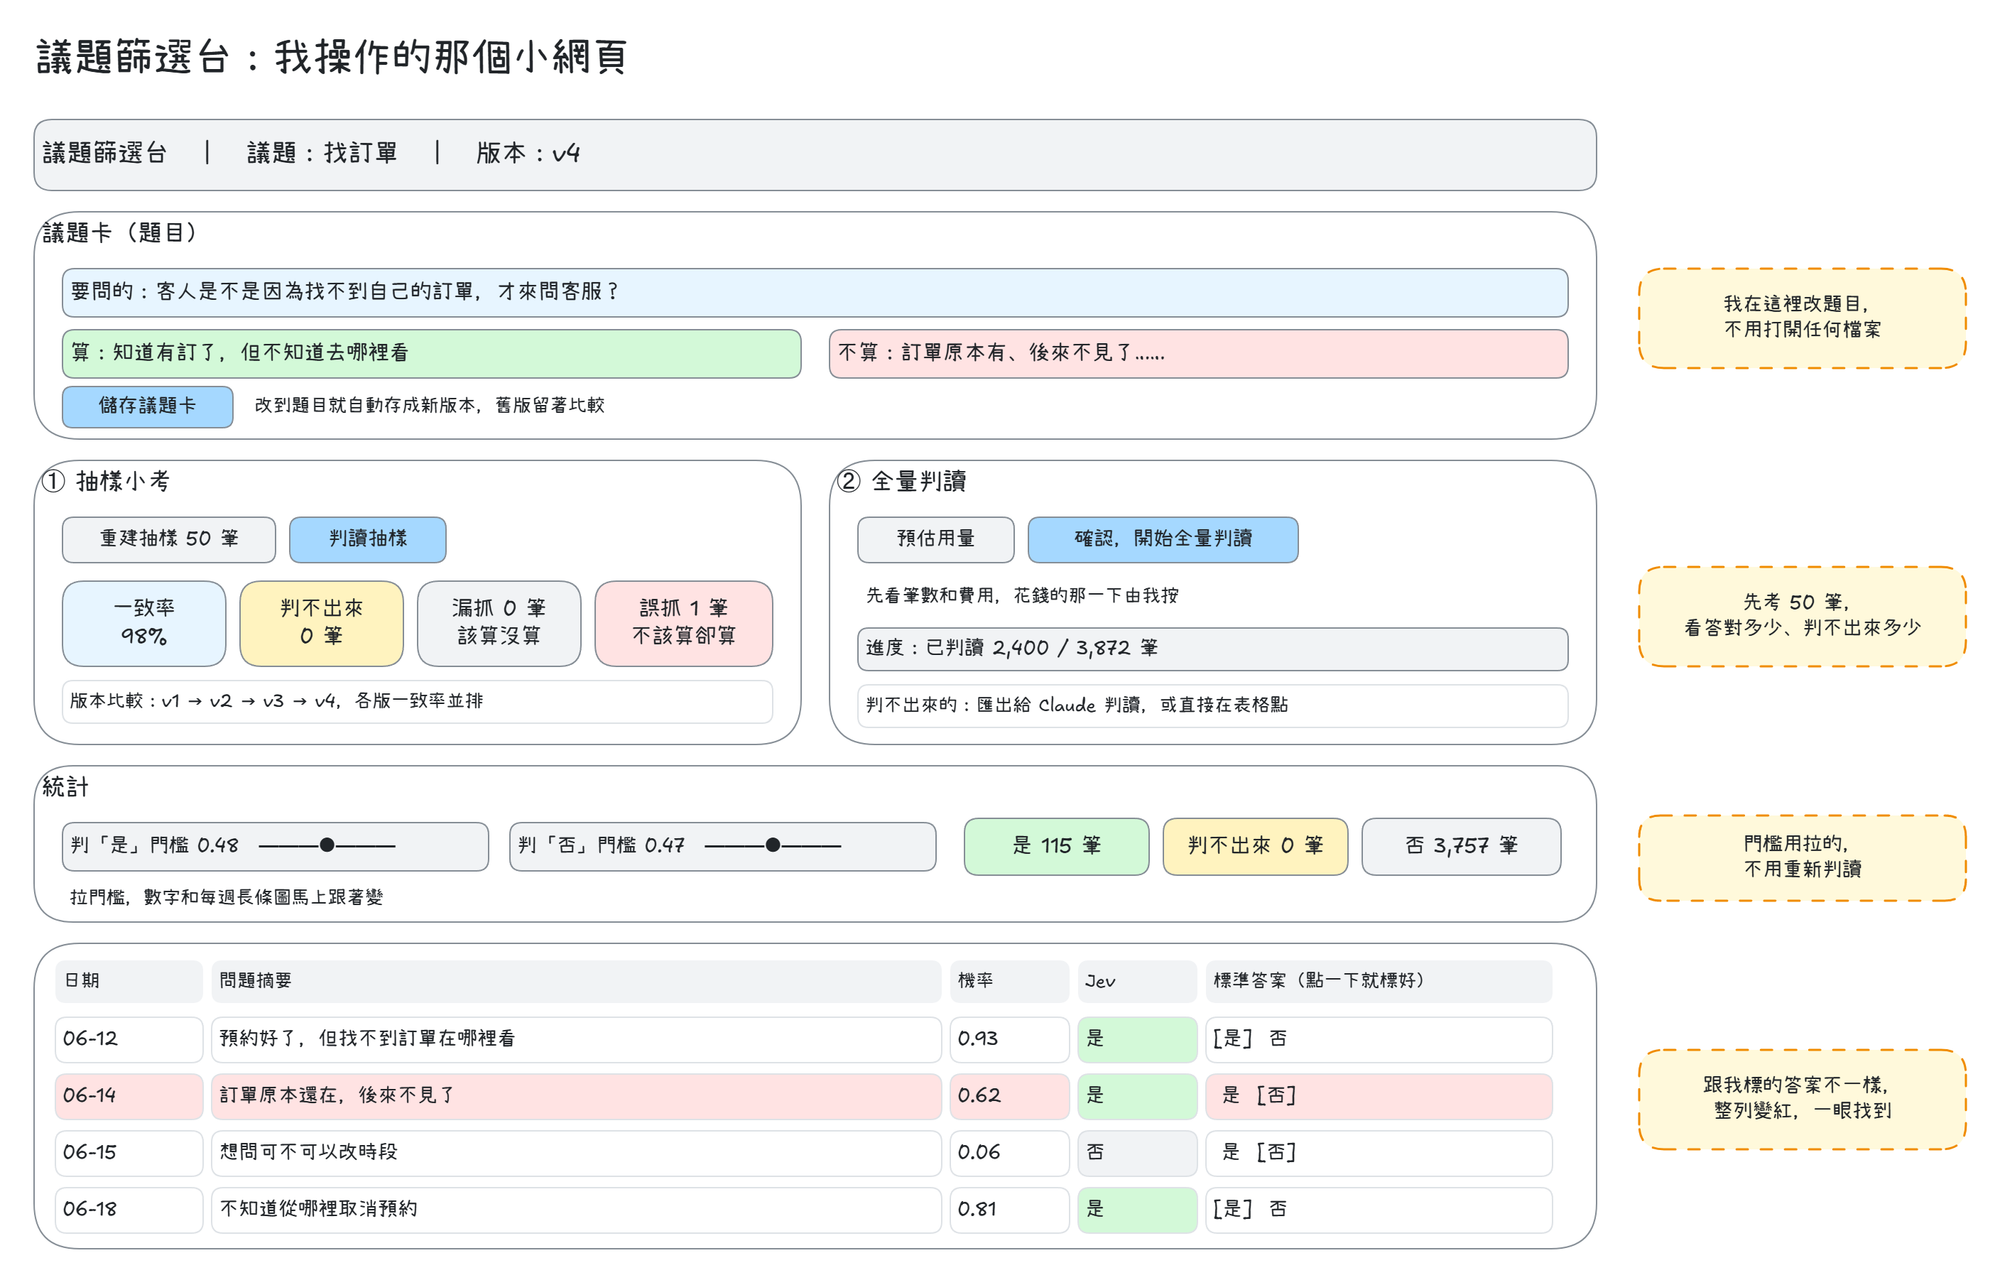
最常用的是這幾個地方:
- 題目直接在網頁上改
議題卡的問題、什麼算、什麼不算,都攤在畫面上。我想到一個邊界,當場改一句、按儲存就好。改到題目會自動存成新版本,舊版留著,各版的一致率可以並排比較。 - 標準答案核對
表格裡每一筆紀錄旁邊有「是/否」兩個按鈕,讓我快速標記標準答案,當 Jev 的答案跟我標的不一樣時,整列會變紅,看紅色的就知道問題在哪。 - 門檻用拉的
Jev 給的是機率,幾分以上算「是」要我來定,用滑桿拉,是、否、判不出來各有幾筆馬上跟著變,不用重新判讀。 - 花錢前先看一眼
全量判讀前,先按「預估用量」看筆數和費用,確認了才開始,花錢的那一下一定是我按。 - 判不出來的交給 Claude
機率卡在中間的紀錄,少的話我直接在表格點;多的話一鍵匯出,請 Claude 逐筆讀完再匯回來。
結語
以前在做這類分析,最花時間的是解析,一筆一筆判斷每個問題到底問題是什麼,才有辦法做出一個具體的改善。
現在這部分交給 AI,很快就跑完,時間反而花在講清楚什麼算、什麼不算、可以怎麼解決。
如果你也想用 AI 來優化客戶反饋的問題,但目前資料量大又沒有結構,建議可以這樣做:
- 拉出原始資料,用你熟悉的 AI 工具先大致分類
- 提出一個你覺得有潛力的具體問題,並且說明什麼算、什麼不算,各舉三個例子寫下來
- 和 AI 協作,根據上面的標準,標記 100 份的正確答案
- 請 AI 抽選 50 題作答,持續調整提問,直到正確率超過 90 %
- 使用高準確率的提問,讓 AI 分析大量的問題